


Introducción
Tener dos servidores protege frente a la pérdida de uno de ellos. La tranquilidad cambia si ambos necesitan la misma pieza para funcionar. El incidente eléctrico que sufrió una zona de Google Cloud en Londres el 20 de octubre de 2026 permite examinar esa dependencia: hubo recursos fuera de servicio y parte del impacto alcanzó otros servicios regionales.
El informe preliminar de Google, publicado el 22 de octubre, sitúa el episodio entre las 06:00 y las 12:10 UTC, las 08:00 y las 14:10 en Madrid. Fueron seis horas y diez minutos. La interrupción afectó a la zona europe-west2-b y no supuso una caída total de Londres. [1]
Según el proveedor, fallaron los controladores automáticos principal y de respaldo que debían conectar los generadores. Al agotarse las baterías, los equipos de esa zona perdieron suministro. El desvío de cargas y las dependencias de validación entre zonas extendieron parte de los efectos a otros recursos regionales. El relato sigue siendo preliminar y procede de la empresa responsable de la infraestructura. [1]
A las 12:10 UTC se había recuperado la disponibilidad para la gran mayoría de las cargas. El aviso de cierre de las 14:03 UTC todavía mencionaba clientes residuales afectados. Distinguir ambos hitos evita dar por terminada la interrupción de todos en la primera hora de recuperación general. [1]
Dos máquinas, una misma dependencia
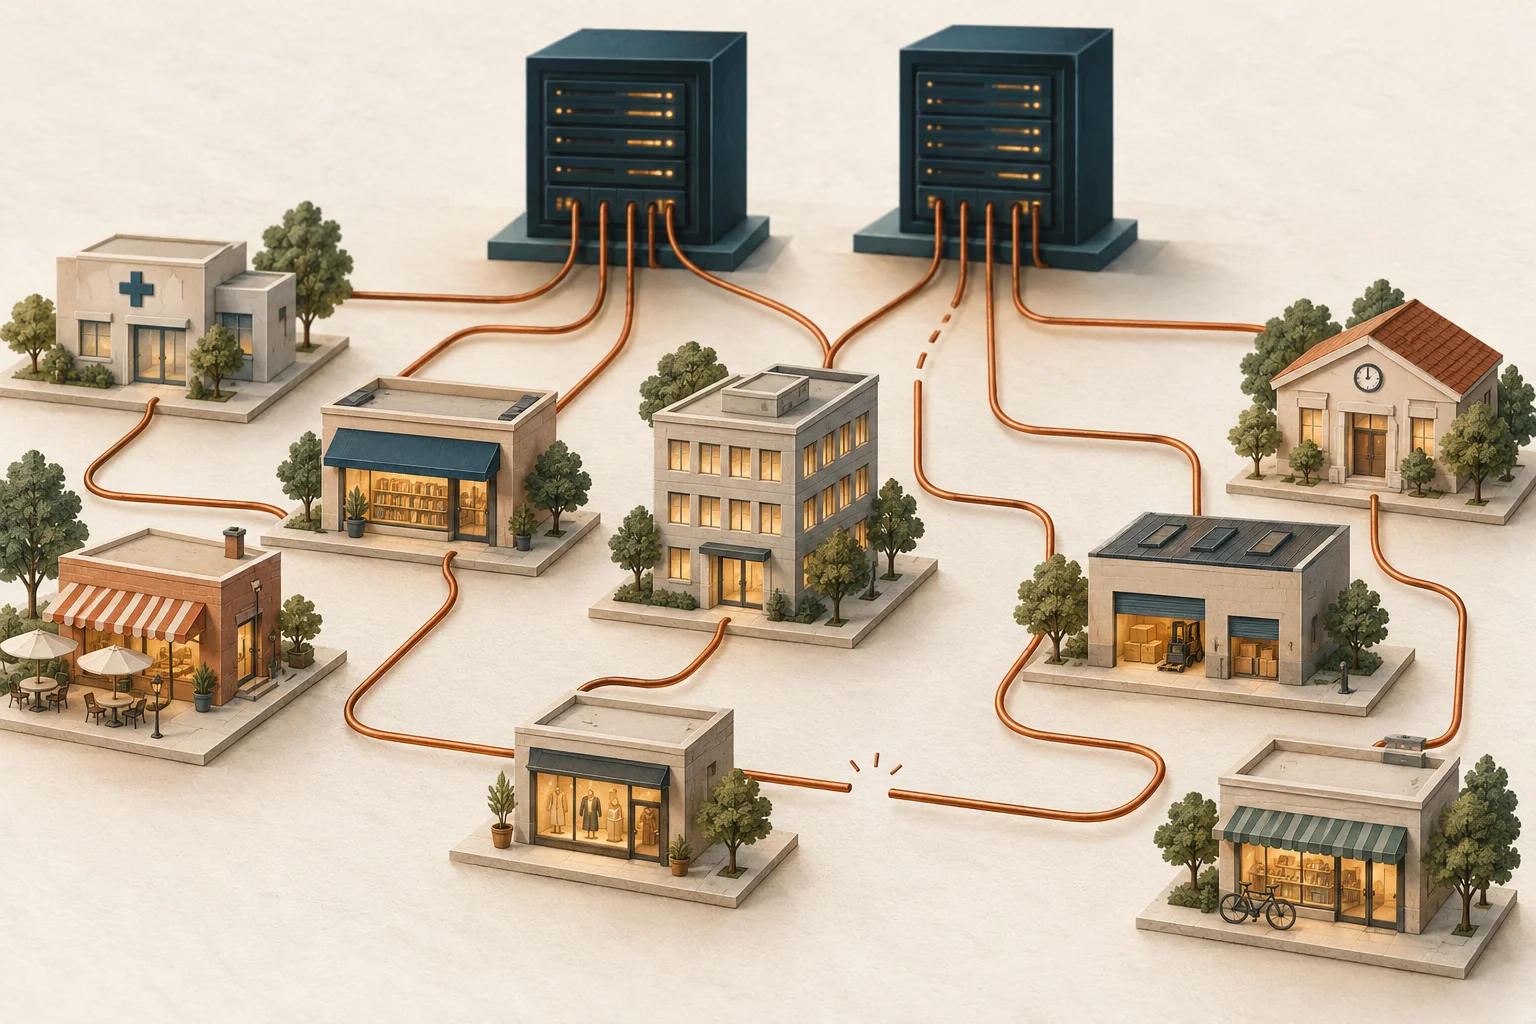
Para entender el problema sirve una aplicación ficticia con dos servidores. Cualquiera de ellos puede atender al usuario, pero ambos necesitan consultar la misma base de datos y el mismo servicio de identificación. Si esa pieza común falla y no hay alternativa, los servidores pueden seguir encendidos mientras la persona no consigue terminar su operación.
El ejemplo no reconstruye la arquitectura de un cliente afectado en Londres. Muestra por qué la redundancia tiene que examinarse desde la función que queremos conservar. La guía de diseño de Google distingue fallos de recursos, zonas y regiones, y recomienda evitar puntos únicos de fallo según el nivel de protección buscado. [2]
Una segunda instalación sería útil si puede completar la operación con los datos y permisos necesarios cuando falta la primera. Si para hacerlo necesita el mismo servicio que se ha interrumpido, el cambio de máquina deja el trabajo atascado en otro sitio. La continuidad depende del recorrido completo, no del número de equipos que hemos comprado.
Por eso una prueba debería llegar hasta la operación importante para el usuario. En nuestro ejemplo, abrir una pantalla no basta si después no podemos confirmar un pedido o recuperar el dato imprescindible. Comprobar esa función permite conocer qué protege realmente la alternativa y qué dependencia sigue compartiendo.
La continuidad tiene un coste, la interrupción también
Multiplicar entornos añade dinero, trabajo y complejidad. Una organización pequeña puede obtener de una gran plataforma capacidades que no podría mantener sola. El incidente no demuestra que abandonar la nube o contratar varios proveedores sea siempre la respuesta más razonable.
La comparación empieza por el daño de perder una función y por el tiempo que se puede soportar sin ella. Una recuperación lenta puede ser asumible para un archivo de consulta y resultar inadecuada para otra operación urgente. Hacer explícita esa diferencia permite elegir una protección proporcionada y probarla, en lugar de pagar por duplicaciones cuyo alcance desconocemos.
La preocupación también alcanza a los reguladores. La FCA anunció el 10 de julio de 2026 que desde el 13 supervisaría, junto al Banco de Inglaterra y la PRA, a los primeros cuatro proveedores críticos designados por el Tesoro: AWS, Google Cloud, Microsoft y Oracle. Su comunicado aborda el riesgo de que una interrupción compartida alcance a varias entidades o mercados y mantiene la responsabilidad de cada entidad financiera sobre sus proveedores. No es un dictamen sobre este episodio. [3]
El caso de Londres muestra la necesidad de preguntar qué permanece común cuando creemos haber duplicado una solución. La calidad de un servicio incluye conocer esas dependencias y ensayar una recuperación acorde con el daño posible. El tamaño del proveedor puede aportar capacidad. La prueba de que la alternativa completa el trabajo aporta una razón para confiar en ella.
Metodología general de la revista
Fuentes
El alcance de las fuentes se limita a los pasajes y periodos atribuidos en el relato. Los ejemplos propios y las interpretaciones se distinguen de los resultados observados.
- [1] Preliminary Incident Report, 22/10/2026, 01:42 PDT — Google Cloud Service Health · fuente primaria · consultada el 23 de octubre de 2026
Informe preliminar sobre causa, recuperación e impacto entre zonas. Las explicaciones del proveedor no constituyen una auditoría independiente del incidente.
- [2] Design reliable infrastructure for your workloads, revisión 23/09/2026 — Google Cloud Architecture Center · fuente primaria · consultada el 21 de octubre de 2026
- [3] UK financial regulators to begin overseeing Critical Third Parties, 10/07/2026 — Financial Conduct Authority · fuente primaria · consultada el 21 de octubre de 2026